

Python i web scraping: jak automatycznie zbierać dane ze stron internetowych
Spis treści:
Ile czasu zajmie przepisanie 15 ofert samochodów do Excela? Kwadrans, jeśli nic się nie pomyli.
Oferty samochodów są na trzech podstronach. Przy każdej ofercie interesują nas cena, rocznik, przebieg, napęd i miasto. Ręczne przepisywanie zajmuje czas i łatwo wtedy o pomyłkę. Skrypt w Pythonie może zebrać te informacje automatycznie, a przy kolejnej aktualizacji wykonać tę samą pracę w kilka chwil.
W tym artykule krok po kroku zbudujemy scraper dla katalogu AutoScope — strony przygotowanej do ćwiczeń. Pokażę, jak pobrać HTML, odczytać dane z kart ofert, przejść przez kolejne podstrony i zapisać wyniki do CSV. Pełny kod znajduje się w artykule.
Jak to działa
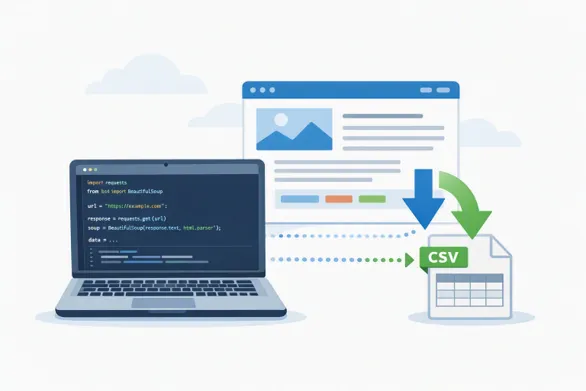
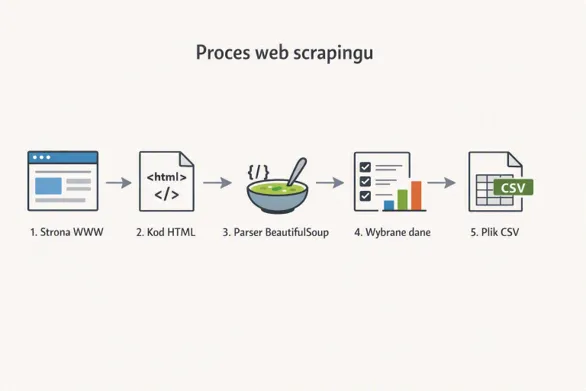
Skrypt wysyła do serwera żądanie HTTP i odbiera odpowiedź, która w tym przykładzie zawiera kod HTML. Przeglądarka interpretuje HTML i wyświetla stronę, a skrypt wyszukuje w kodzie wybrane elementy, na przykład nazwy, ceny i linki. Zebrane informacje można następnie zapisać do pliku CSV, otworzyć w Excelu i wykorzystać do dalszej analizy.
Zanim zaczniesz
Przed pobieraniem danych sprawdź regulamin serwisu i jego zasady dotyczące automatycznego dostępu. Warto też zajrzeć do pliku robots.txt (np. adres-strony.pl/robots.txt), który informuje roboty, do jakich części serwisu właściciel nie chce ich dopuszczać. Sam plik robots.txt nie jest jednak zgodą prawną na pobieranie danych. Jeśli dostępne jest oficjalne API (Application Programming Interface), zwykle warto zacząć właśnie od niego. Nie wysyłaj dużej liczby żądań jedno po drugim i nie zbieraj danych osobowych bez odpowiedniej podstawy. Publicznie widoczny numer telefonu również może być daną osobową.
Strona do ćwiczeń
Katalog AutoScope znajduje się pod adresem https://beje.pl/python/oferty_demo.php. Strona przypomina serwis z ogłoszeniami: ma wyszukiwarkę, karty samochodów, ceny, raty i wyróżnioną ofertę. Dane podzielono na trzy podstrony, po pięć ofert na każdej.
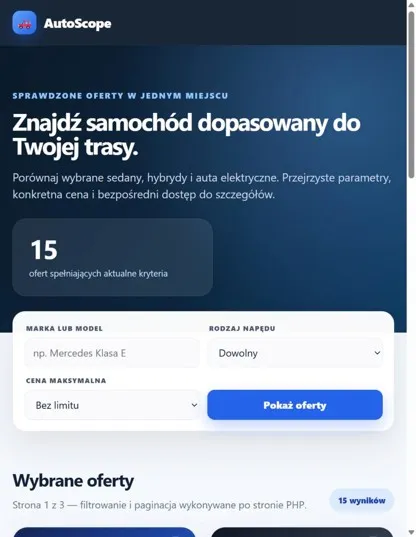
Strona startowa katalogu AutoScope
Kliknij „2” pod listą ofert i sprawdź pasek adresu. Pojawi się parametr ?page=2. Po wybraniu napędu lub maksymalnej ceny mogą pojawić się kolejne parametry, np. ?fuel=Hybryda albo ?price_max=150000. Ponieważ parametry są widoczne w adresie, w tym ćwiczeniu nie trzeba automatyzować klikania — wystarczy wysłać żądanie z odpowiednimi parametrami.
Zaglądamy do HTML-a
Kliknij prawym przyciskiem myszy cenę dowolnego auta i wybierz „Zbadaj” (lub naciśnij Ctrl+Shift+C). W narzędziach deweloperskich zobaczysz fragment HTML odpowiadający za wskazany element.
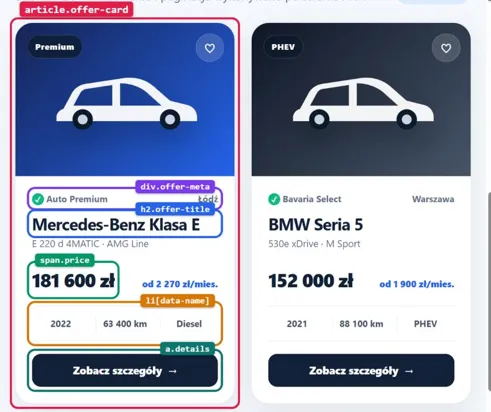
Karta oferty i elementy HTML, z których skrypt pobiera dane
Każda oferta znajduje się w elemencie article z klasą offer-card. Poniżej uproszczony fragment HTML jednej karty:
<article class="offer-card promoted" data-id="O00217">

  <div class="offer-meta">
    <span><span class="verified">✓</span> Centrum Aut</span>
    <span>Poznań</span>
  </div>

  <h2 class="offer-title">Volkswagen Arteon</h2>

  <p class="model-note">2.0 TDI 4Motion · R-Line</p>

  <span class="price" data-value="117900">117 900 zł</span>

  <ul class="parameters">
    <li data-name="year">2020</li>
    <li data-name="mileage">121 000 km</li>
    <li data-name="fuel">Diesel</li>
  </ul>

  <a class="details" href="/oferty/O00217">Zobacz szczegóły</a>

</article>
Warto zwrócić uwagę na sposób zapisania ceny. Tekst „117 900 zł” jest przeznaczony dla osoby czytającej stronę, a atrybut data-value zawiera wartość 117900, którą łatwiej wykorzystać w obliczeniach. Rok, przebieg i rodzaj paliwa mają atrybut data-name. Dzięki temu można je rozpoznać po nazwie, zamiast zakładać, że zawsze występują w tej samej kolejności. Klasa promoted oznacza ofertę wyróżnioną.
Elementy wskazuje się selektorami CSS, tymi samymi, których używa się w arkuszach stylów:
Selektor
Co oznacza
.price
element z klasą price (kropka = klasa)
#offers
element o identyfikatorze offers (# = id)
article.offer-card
znacznik article z klasą offer-card
ul.parameters li
każdy li wewnątrz listy z klasą parameters
.offer-meta > span
span leżący bezpośrednio w .offer-meta
li[data-name="year"]
li z atrybutem data-name równym year
Pierwszy skrypt
Do przykładu wykorzystamy dwie biblioteki: requests do wysłania żądania HTTP oraz BeautifulSoup do wyszukania elementów w otrzymanym HTML-u.
Na początek pobierzemy pierwszą podstronę i wyświetlimy nazwy modeli wraz z cenami.
Parametr timeout=10 ogranicza czas oczekiwania na odpowiedź serwera. Metoda raise_for_status() zgłasza błąd, jeśli serwer zwróci status HTTP z zakresu 4xx lub 5xx. Bez tej kontroli skrypt mógłby próbować analizować HTML strony błędu, a wynik wyglądałby po prostu na brak ofert. Metoda select() zwraca wszystkie pasujące elementy, a select_one() — pierwszy z nich. get_text(strip=True) pobiera tekst i usuwa zbędne białe znaki z jego początku i końca.
Dwie pułapki
Na pierwszej podstronie jest pięć ofert. Zanim pobierzemy cały katalog, trzeba obsłużyć dwa przypadki: brak jednego z parametrów w karcie oraz sposób ustalania liczby podstron. Oba problemy często pojawiają się przy pracy z rzeczywistymi stronami.
Pierwsza: Toyota Camry nie ma podanego przebiegu.
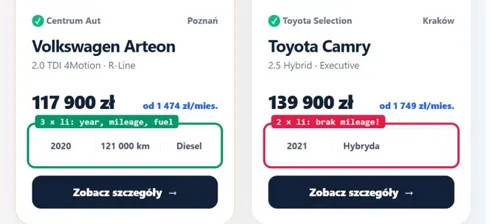
W karcie Toyoty Camry brakuje elementu z przebiegiem
Jeśli szukany element nie istnieje, select_one() zwróci None. Wywołanie .get_text() na takiej wartości spowoduje błąd AttributeError. W tym przykładzie parametry zapisujemy więc w słowniku, a następnie pobieramy metodą get(). Jeśli danego klucza nie ma, metoda zwróci None i możemy odpowiednio obsłużyć brak danych.
Drugi przypadek dotyczy paginacji, czyli podziału wyników na kolejne strony.
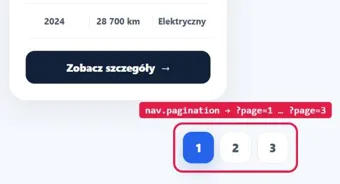
Kolejne podstrony to ten sam adres z innym parametrem page
Można próbować zwiększać numer strony, aż lista ofert będzie pusta. W tym katalogu takie podejście nie zadziała: żądanie z parametrem ?page=4 ponownie wyświetla trzecią stronę. Pętla mogłaby wtedy przetwarzać te same oferty bez końca. Dlatego skrypt odczytuje numer ostatniej strony z elementów paginacji.
Cały skrypt
Poniższy skrypt pobiera kolejne podstrony, odczytuje dane z każdej karty i zapisuje zebrane rekordy do pliku CSV.
Pętla while działa, dopóki numer bieżącej strony nie przekroczy wartości ostatnia. Początkowo ustawiamy ostatnia = 1, ponieważ przed pierwszym żądaniem nie znamy liczby stron. Po pobraniu strony skrypt odczytuje numery z paginacji i aktualizuje tę wartość. Jeśli paginacji nie ma, max(numery, default=1) zwróci 1.
Obiekt Session pozwala korzystać z jednej sesji przy kolejnych żądaniach. Ustawiamy w niej również nagłówek User-Agent. Słownik parametry_url biblioteka requests zamienia na parametry adresu, więc nie trzeba ręcznie łączyć tekstu, np. ’?page=’ + str(strona).
Cena jest pobierana z atrybutu data-value, więc od razu otrzymujemy liczbę. Przebieg zapisano jako tekst, np. „63 400 km”, dlatego wyrażenie regularne \D usuwa znaki inne niż cyfry i pozwala uzyskać wartość 63400. Link w karcie jest względny (np. /oferty/O00217), a urljoin() łączy go z adresem serwisu.
Filtry bez dodatkowego kodu
Aby pobrać tylko samochody w cenie do 150 000 zł, zmień wartość FILTRY na początku skryptu:
W tym katalogu odnośniki paginacji uwzględniają wybrany filtr, więc po jego zastosowaniu skrypt odczyta nową liczbę stron. Nazwy parametrów można sprawdzić w pasku adresu po użyciu formularza wyszukiwania.
CSV, Excel i polskie znaki
Excel nie zawsze poprawnie rozpoznaje polskie znaki w pliku CSV zapisanym jako UTF-8. Kodowanie utf-8-sig dodaje na początku pliku znacznik BOM, który pomaga Excelowi rozpoznać kodowanie. Używamy też średnika jako separatora kolumn, co często lepiej pasuje do polskich ustawień regionalnych Excela.
Plik można następnie wczytać do pandas (instalacja: pip install pandas) i policzyć podstawowe statystyki cen dla poszczególnych rodzajów napędu:
Gdy coś nie działa
Niektóre strony pobierają dane dopiero za pomocą JavaScriptu. W takim przypadku requests może otrzymać HTML, w którym nie ma jeszcze ofert. Zanim użyjesz narzędzia takiego jak Playwright, sprawdź w narzędziach deweloperskich kartę Network. Dane mogą być pobierane osobnym żądaniem, czasem w formacie JSON.
Status HTTP 403 oznacza, że serwer odmawia dostępu do zasobu. Czasem serwer wymaga odpowiednich nagłówków, ale nie należy próbować omijać świadomych zabezpieczeń ani zasad dostępu serwisu.
Jeśli skrypt działał wcześniej, a teraz nie znajduje ofert, sprawdź, czy zmieniła się struktura HTML lub nazwy klas CSS. Otwórz narzędzia „Zbadaj” i porównaj aktualny kod strony z selektorami używanymi w skrypcie.
Zadanie na koniec
Na koniec spróbuj samodzielnie rozbudować skrypt. Możesz na przykład:
- pobierz tylko auta elektryczne (fuel=Elektryczny) i policz ich średni przebieg,
- dodaj kolumnę z ratą miesięczną, którą strona trzyma w elemencie z klasą finance,
- zapisz wyniki dodatkowo do pliku Excela metodą to_excel() z pandas.
Wszystkie potrzebne elementy zostały pokazane w przykładach powyżej.